Proyecto de análisis de texto y narrativa de datos que aplica modelado de tópicos y análisis de sentimiento a 295 presentaciones públicas a la consulta federal australiana de 2025. Calificado con H y 90/100.
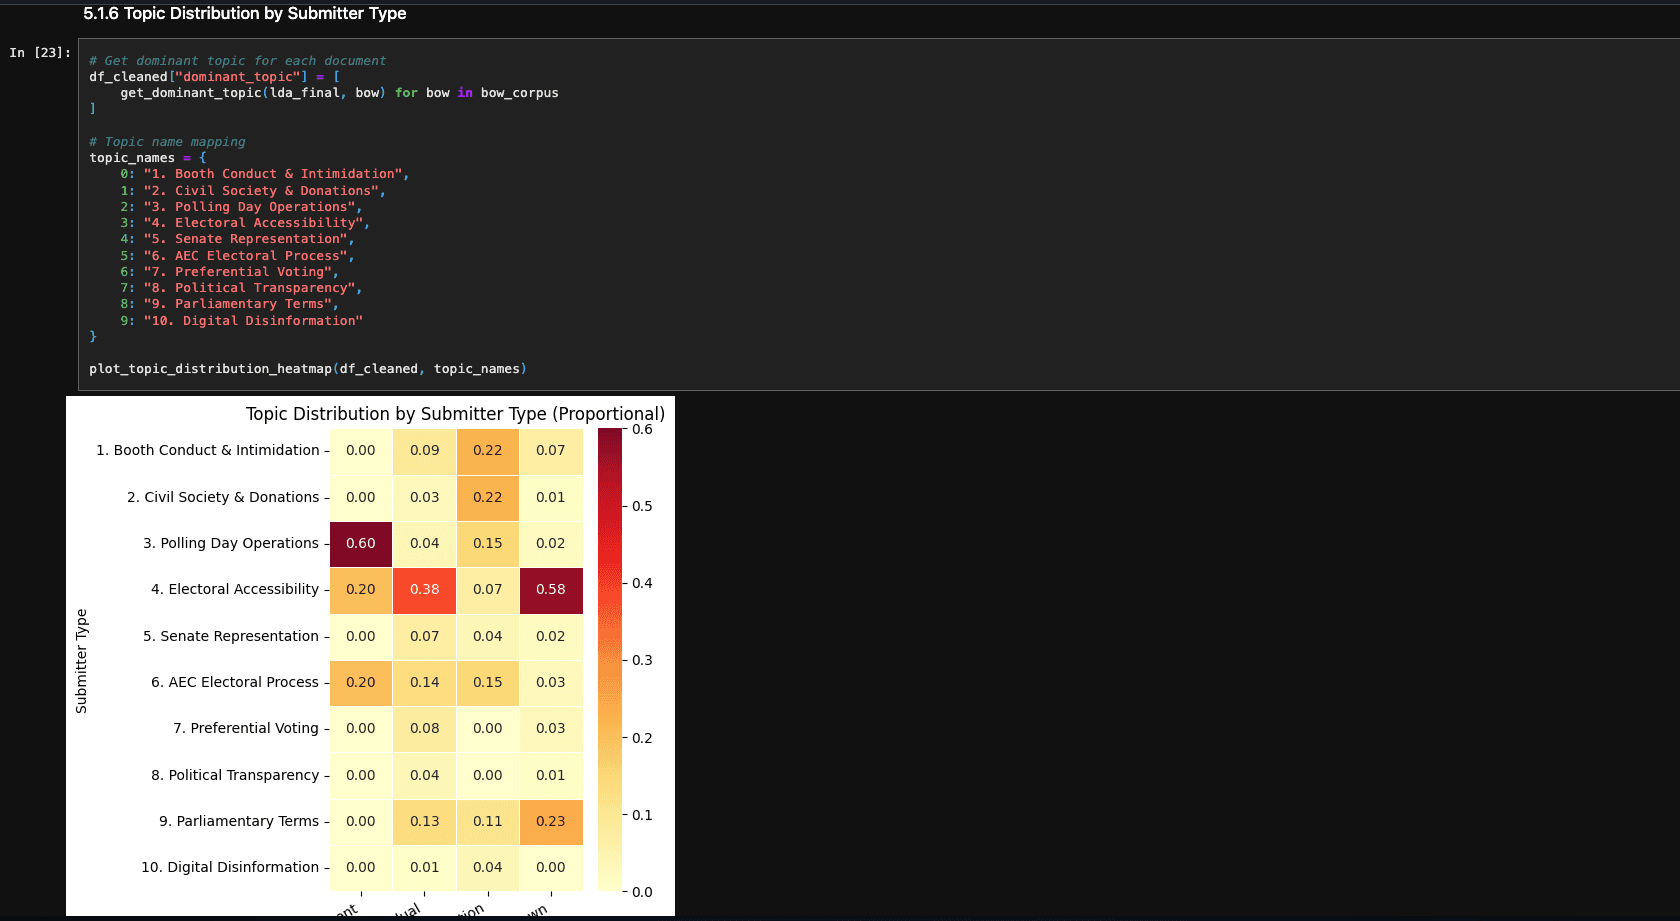
Proyecto de análisis de texto exploratorio aplicado a 295 presentaciones públicas a la consulta parlamentaria australiana sobre la conducta de las elecciones federales de 2025, publicadas por el Comité Conjunto Permanente sobre Asuntos Electorales (JSCEM). La pregunta de investigación exploró cómo las presentaciones caracterizan la relación entre la desinformación digital y la intimidación electoral, y cómo esa percepción varía según el tipo de presentador. El pipeline usa NLTK, spaCy, Gensim LDA, VADER, TextBlob y TF-IDF de scikit-learn para modelado de tópicos, análisis de sentimiento y clasificación de presentadores. La extracción de PDFs maneja documentos nativos y escaneados mediante pdfplumber, PyMuPDF y pytesseract con fallback a OCR. Los hallazgos se sintetizaron en un reporte narrativo en markdown que combina visualizaciones y análisis escrito. Completado como parte de la materia de Procesamiento de Lenguaje Natural Aplicado en UTS. Calificado con H y 90/100.
